AI Security e LLM Red Teaming: testare il sistema prima che lo faccia un attaccante
Integrare un modello di intelligenza artificiale in un’applicazione non significa soltanto aggiungere una nuova tecnologia.
Significa introdurre una nuova superficie di attacco.
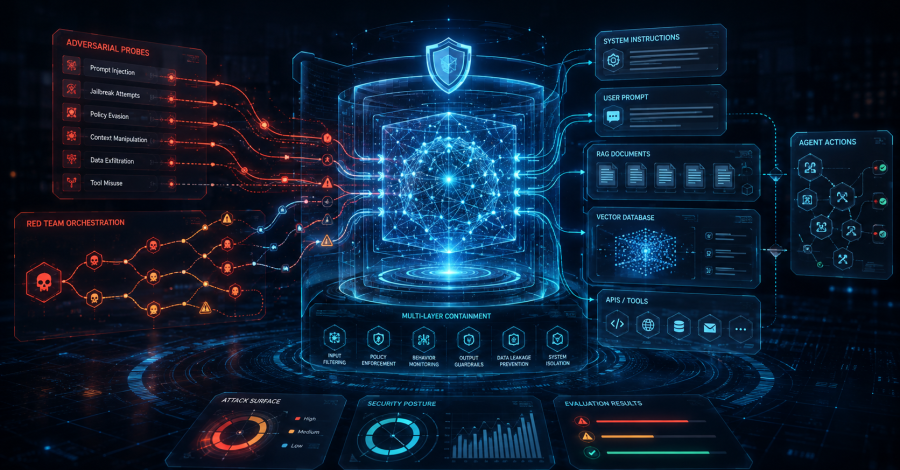
Prompt, dati, modelli, RAG, API, tool, agenti e sistemi esterni possono creare vulnerabilità che la sicurezza applicativa tradizionale non intercetta completamente.
L’AI Security serve a individuare questi rischi.
Il LLM Red Teaming serve a metterli alla prova attraverso test avversariali controllati, cercando di comprendere come un modello possa essere manipolato, aggirato o utilizzato in modo diverso da quello previsto.
In breve
AI Security è la disciplina che protegge modelli, applicazioni e infrastrutture basate sull’intelligenza artificiale da vulnerabilità e manipolazioni. Il LLM Red Teaming verifica in modo avversariale come un sistema AI reagisce a prompt injection, jailbreak, data poisoning, model backdoor, leakage di informazioni, abuso di tool, RAG e agenti autonomi.
Il perimetro di sicurezza comprende l’intera architettura: dati, API, vector database, autorizzazioni, identità, strumenti esterni e sistemi collegati. Michaela Odderoli applica questo approccio all’analisi dei sistemi AI integrando cybersecurity, threat analysis, intelligence e testing avversariale, con l’obiettivo di individuare vulnerabilità, valutarne l’exploitability e trasformare i risultati in misure di mitigazione concrete.
La sicurezza non riguarda soltanto il modello
Un sistema basato su AI è una catena.
Può comprendere modello, system prompt, dati di contesto, vector database, RAG, plugin, API, strumenti esterni, autorizzazioni e identità degli utenti.
Una vulnerabilità in uno solo di questi livelli può modificare il comportamento dell’intero sistema.
Tra i rischi da analizzare rientrano:
- prompt injection diretta e indiretta;
- jailbreak e bypass delle restrizioni;
- system prompt leakage;
- esposizione di informazioni sensibili;
- data e model poisoning;
- gestione non sicura degli output;
- excessive agency;
- abuso di tool e funzioni;
- vulnerabilità della supply chain;
- model extraction e utilizzo improprio delle API.
Il riferimento internazionale OWASP Top 10 for LLM Applications organizza molte di queste classi di rischio e costituisce una base utile per strutturare l’assessment.
Prompt injection e manipolazione del contesto
Un LLM interpreta istruzioni.
Il problema nasce quando non distingue correttamente quali istruzioni debbano avere autorità e quali no.
Una prompt injection può essere inserita direttamente dall’utente oppure arrivare indirettamente attraverso documenti, pagine web, email, database o altre fonti elaborate dal sistema.
In applicazioni collegate a RAG o agenti, il rischio aumenta perché il modello non produce soltanto testo: può accedere a informazioni, utilizzare strumenti o generare azioni.
Il test deve quindi verificare non soltanto “cosa risponde il modello”, ma cosa il sistema permette al modello di fare.
LLM Red Teaming
Il Red Teaming applicato agli LLM cerca di osservare il sistema dal punto di vista dell’avversario.
L’obiettivo non è ottenere una risposta curiosa dal chatbot.
È individuare condizioni nelle quali l’AI possa:
- ignorare istruzioni;
- rivelare informazioni;
- utilizzare impropriamente dati o strumenti;
- produrre output pericolosi per sistemi downstream;
- essere manipolata attraverso contenuti esterni;
- superare separazioni tra utenti o contesti;
- eseguire sequenze operative non previste;
- trasformare una vulnerabilità del modello in un rischio applicativo.
Un test efficace deve essere ripetibile, documentato e correlato all’architettura reale nella quale il modello opera.
RAG, agenti e nuove superfici di attacco
RAG e sistemi agentici aumentano le capacità dell’AI, ma anche il numero di relazioni da proteggere.
Un sistema può interrogare documenti interni, database, CRM, repository, servizi cloud o API.
Un agente può inoltre selezionare autonomamente strumenti e concatenare azioni.
Diventano quindi centrali:
controllo degli accessi, separazione dei privilegi, validazione degli input e degli output, autorizzazione delle azioni, logging e monitoraggio.
Il principio è semplice:
un modello non dovrebbe poter utilizzare più dati, privilegi o strumenti di quelli strettamente necessari al proprio compito.
Backdoor, poisoning e compromissione del modello
La sicurezza deve considerare anche ciò che avviene prima dell’interazione con l’utente.
Dataset, fine-tuning, modelli di terze parti, componenti open source e pipeline di sviluppo possono introdurre comportamenti inattesi o deliberatamente malevoli.
Backdoor e poisoning sono particolarmente critici perché un modello può comportarsi normalmente fino alla comparsa di uno specifico trigger.
Ho approfondito questo tema nell’analisi Come rilevare le Backdoor AI.
Dalla vulnerabilità al rischio reale
Non tutte le anomalie di un modello hanno lo stesso impatto.
Una risposta non prevista può essere irrilevante in un ambiente sperimentale e critica se il sistema ha accesso a dati riservati, API, infrastrutture o processi aziendali.
Per questo distinguo sempre:
vulnerabilità — debolezza individuata;
exploitability — possibilità concreta di sfruttarla;
impatto — conseguenze tecniche e operative;
mitigazione — controllo necessario per ridurre il rischio;
rischio residuo — ciò che rimane dopo l’applicazione delle misure di sicurezza.
Il Red Teaming non deve produrre soltanto una raccolta di prompt riusciti.
Deve produrre informazioni utilizzabili per correggere il sistema.
Il mio approccio
Sono Michaela Odderoli, cybersecurity specialist, analista di Cyber Intelligence e consulente forense.
Da 36 anni lavoro nella sicurezza informatica e applico l’approccio avversariale anche ai sistemi di intelligenza artificiale, con particolare attenzione ad AI Security, LLM Red Teaming, threat analysis, social engineering e comportamento dei sistemi.
Il principio rimane quello della sicurezza tradizionale:
non considero sicuro un sistema perché funziona come previsto.
Cerco di capire cosa succede quando qualcuno prova intenzionalmente a farlo funzionare in modo diverso da quello previsto.
Sono inoltre CEO di Pragmat AI S.r.l., società attiva nello sviluppo di sistemi di intelligenza artificiale predittiva e intelligence.
Approfondimenti
Sul sito approfondisco anche alcune delle tecniche e delle vulnerabilità che fanno parte di questo perimetro:
Come rilevare le Backdoor AI
Trigger, comportamenti anomali e compromissione dei modelli.
Il mito del Prompt di Dio
Limiti dei prompt, comportamento dei modelli e falsa percezione del controllo.
Chub AI: dove nascono le identità artificiali
Identità artificiali, interazione uomo-macchina e superfici di rischio emergenti.
Interventi e attività professionali sono raccolti anche nella pagina Pubblicazioni e Riconoscimenti.
Sicurezza prima della fiducia
Un sistema AI può essere accurato e contemporaneamente vulnerabile.
Può rispettare perfettamente il comportamento previsto fino al momento in cui riceve un input costruito per violarne le assunzioni.
Per questo AI Security e LLM Red Teaming devono rispondere a una domanda molto concreta:
cosa può fare questo sistema quando qualcuno smette di utilizzarlo come avevamo previsto?
Per attività di AI Security, assessment o LLM Red Teaming puoi contattarmi direttamente.