L’AI non è neutrale: come e perché amplifica i bias umani
L’AI come specchio deformante dell’umanità: riflette e amplifica i nostri bias.
Ogni volta che si parla di intelligenza artificiale, salta fuori la frase: “è neutrale, non ha emozioni, non ha pregiudizi”.
È una bugia rassicurante, comoda da raccontare per vendere tecnologia o per tranquillizzare chi teme decisioni automatiche.
La verità è che l’AI è uno specchio deformante dell’umanità: riflette ciò che le diamo in pasto, ma non lo restituisce mai identico. Lo ingrandisce, lo rielabora secondo logiche matematiche e statistiche, e lo rilascia in forma amplificata, spesso priva del contesto umano che ne attenuava l’impatto.
Un bias espresso da una persona può influenzare un gruppo ristretto; lo stesso bias, codificato in un modello di AI e applicato su larga scala, può condizionare milioni di decisioni in pochi secondi. È il passaggio dal sussurro privato a un megafono planetario.
L’illusione della neutralità nasce dal fatto che il “pensiero” dell’AI è invisibile, tradotto in numeri e calcoli che sembrano impersonali. Ma quei numeri sono il prodotto di dati storici, selezioni umane, scelte di design e filtri culturali. In altre parole, dietro l’apparente oggettività c’è sempre una catena di decisioni soggettive.
Ignorare questo significa consegnare potere decisionale a un sistema che non solo eredita i nostri errori, ma li scala, li distribuisce e li rende più difficili da individuare.
Il mito della neutralità
L’AI riflette e amplifica i bias presenti nei dati con cui viene addestrata
Molti immaginano l’AI come un arbitro imparziale, capace di decidere senza lasciarsi influenzare da ideologie, emozioni, disinformazione o distorsioni culturali. È un’immagine rassicurante, utile alle aziende che la sviluppano per venderla come “oggettiva” e ai decisori per giustificare scelte automatizzate.
La realtà è molto diversa: non esiste alcun algoritmo “vergine”. Ogni modello di intelligenza artificiale nasce da un’operazione di addestramento che avviene su grandi quantità di dati: testi, immagini, registrazioni, numeri, interazioni sociali.
Questi dati non sono neutrali: contengono il peso di decenni, secoli o millenni di bias umani, sedimentati nella lingua, nei contenuti culturali, nei sistemi politici ed economici che li hanno generati.
Anche quando si tenta di “ripulire” i dataset, la selezione stessa è una scelta soggettiva: decidere cosa includere o escludere significa già imporre un punto di vista. Persino i criteri con cui si valuta la “correttezza” dell’output — metriche, benchmark, feedback umani — sono influenzati da norme sociali, interessi economici e ideologie dominanti.
Il mito della neutralità dell’AI è quindi un equivoco pericoloso: spinge a credere che i risultati di un algoritmo siano verità assolute, quando in realtà sono proiezioni statistiche filtrate da un contesto umano, con tutti i suoi limiti e distorsioni.
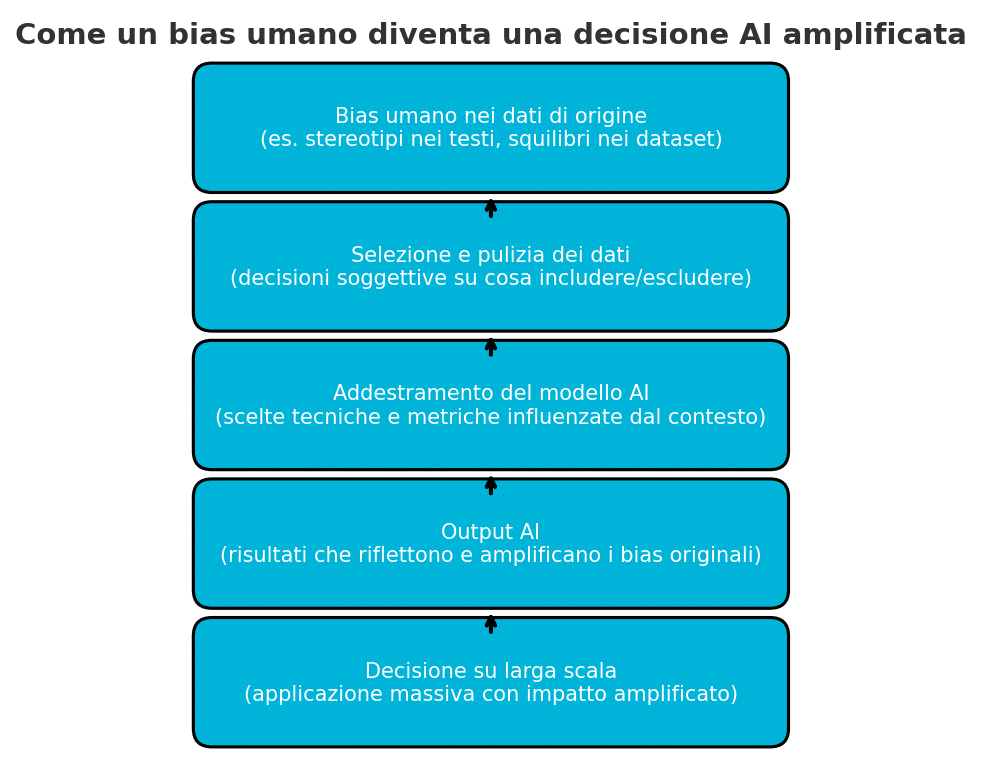
Dal dato distorto alla decisione automatizzata: il percorso di amplificazione del bias nell’AI.
Cosa sono i bias nell’ AI
I bias sono distorsioni sistematiche che influenzano il modo in cui un sistema prende decisioni o genera risposte.
Nell’AI, queste distorsioni non sono accidentali: derivano da come i dati vengono raccolti, filtrati, interpretati e trasformati in modelli matematici.
Nella pratica, le principali fonti di bias in un modello di intelligenza artificiale sono:
1. Dati di addestramento
Tutto ciò che un modello impara dipende dai dati su cui è stato addestrato.
Questi dati provengono dal mondo reale e portano con sé errori, stereotipi, squilibri demografici e culturali.
Esempi concreti:
-
Sistemi di riconoscimento facciale che funzionano meglio su volti maschili bianchi perché i dataset erano sbilanciati (Fonte: MIT Media Lab).
-
Algoritmi di traduzione automatica che, in lingue senza genere grammaticale, associano ruoli di lavoro a un genere specifico (“il medico” → maschio, “l’infermiera” → femmina).
Rischio: se il bias è nei dati, il modello lo eredita e lo normalizza.
2. Scelte progettuali
Anche con dati “perfetti”, le decisioni prese durante la progettazione di un modello influiscono sugli output.
Cosa include:
-
Quali dati includere o escludere (criteri di filtraggio e campionamento).
-
Quali metriche di accuratezza usare (precisione, recall, F1 score… ognuna privilegia un aspetto diverso).
-
Quali obiettivi ottimizzare: ad esempio, ridurre i falsi positivi potrebbe aumentare i falsi negativi e viceversa.
Esempio reale: nel sistema di valutazione dei detenuti COMPAS, usato in tribunali USA, la scelta di ottimizzare la previsione di recidiva ha portato a punteggi più alti (e quindi pene più severe) per alcune minoranze etniche (Fonte: ProPublica).
3. Interventi di “correzione”
Per mitigare i bias, si introducono filtri, regole e linee guida. Tuttavia, anche questi interventi sono scelte soggettive che possono introdurre altri tipi di distorsione.
Esempi concreti:
-
Moderazione automatica dei contenuti che rimuove termini considerati “offensivi” anche quando sono usati in contesti educativi o di denuncia (es. discussioni su razzismo o discriminazioni).
-
Sistemi di valutazione del linguaggio che penalizzano stili comunicativi tipici di determinate culture.
Paradosso: un intervento correttivo mal progettato può ridurre un tipo di bias ma amplificarne un altro.
| Fonte di bias | Descrizione | Esempio |
|---|---|---|
| Dati di addestramento | Testi, immagini, video, audio e statistiche del mondo reale: spesso contengono stereotipi, pregiudizi e squilibri che il modello eredita. | Riconoscimento facciale meno accurato per volti femminili o con pelle scura (cfr. studio MIT “Gender Shades”). |
| Scelte progettuali | Criteri di inclusione/esclusione dei dati, metriche ottimizzate (precision/recall/F1), obiettivi del modello: ogni scelta introduce trade-off. | Sistema COMPAS: punteggi di rischio recidiva con disparità per minoranze (inchiesta ProPublica). |
| Interventi di correzione | Filtri, moderazioni e policy per “ripulire” l’output possono generare nuovi bias o penalizzare linguaggi/contesti legittimi. | Moderazione automatica che rimuove contenuti educativi su hate speech perché manca il contesto. |
Perché amplifica il problema
L’AI agisce come un megafono digitale che amplifica i bias umani, diffondendoli in modo rapido e su vasta scala
L’AI non si limita a replicare il bias: lo potenzia esponenzialmente.
Un pregiudizio umano espresso in una conversazione privata può condizionare solo un piccolo gruppo di persone.
Lo stesso bias, quando viene incorporato in un algoritmo, diventa parte integrante di un sistema capace di prendere decisioni su larga scala e in tempo reale.
Questo significa che un errore o una distorsione non rimangono confinati: vengono replicati milioni di volte, senza pause e senza controllo umano immediato.
Se un essere umano può correggersi dopo un confronto o un ripensamento, un modello AI continuerà a applicare lo stesso schema decisionale distorto finché non viene individuato e modificato il bias alla radice.
È l’equivalente digitale di un megafono senza tasto “mute”, che diffonde pregiudizi e distorsioni con un raggio d’azione globale.
In contesti critici come la giustizia predittiva, l’assunzione di personale o l’accesso al credito, questo effetto moltiplicatore può generare impatti sistemici: discriminazioni strutturate, esclusioni su larga scala e un rafforzamento delle stesse disuguaglianze che l’AI, in teoria, dovrebbe ridurre.
📌 Approfondimento OCSE / OECD sul bias algoritmico
Quadro di riferimento e risorse ufficiali sull’impatto dei bias nelle decisioni automatizzate e sulle buone pratiche di mitigazione.
Cosa fare
Supervisione umana e trasparenza: i pilastri per ridurre i bias nell’AI
-
Eseguire audit regolari sui modelli: l’AI non si può “mettere in automatico” e dimenticare. Ogni output va analizzato e validato nel tempo.
-
Garantire dataset realmente rappresentativi: includere dati bilanciati che riflettano tutte le categorie coinvolte, evitando squilibri sistematici.
-
Rendere trasparenti le decisioni umane: dichiarare chiaramente filtri, regole e criteri adottati in ogni fase del processo.
-
Integrare supervisione continua: prevedere un controllo umano capace di bloccare, correggere o contestualizzare le decisioni dell’AI.
-
Promuovere responsabilità condivisa: i risultati dell’AI sono una responsabilità collettiva, non di un algoritmo isolato.
L’AI non è un giudice imparziale. È un amplificatore dei nostri pregiudizi. L’unico modo per ridurre il rischio è riconoscere la sua natura di strumento — potente, ma fallibile — e trattarlo con lo stesso rigore con cui controlleremmo qualsiasi sistema critico.
Chi si affida ciecamente alla “macchina imparziale” rischia di delegare decisioni vitali a un riflesso potenziato delle nostre stesse distorsioni.