Backdoor AI: Guida Completa per Addetti ai Lavori
Come riconoscere il pensiero “deviato” di un’AI: il caso delle backdoor nei modelli intelligenti.
Quando si parla di intelligenza artificiale, la vera minaccia non è solo l’errore, ma l’intenzionalità nascosta. Una backdoor AI è un comportamento incorporato artificialmente all’interno di un modello che si attiva solo in presenza di determinati input — come un cavallo di Troia digitale. In pratica: un modello può sembrare affidabile finché non riceve “la parola magica”. A quel punto, inizia a comportarsi in modo non previsto, e spesso pericoloso.
Questa guida non è scritta per fare impressione, ma per offrire strumenti pratici a chi si occupa di cybersecurity, compliance e AI engineering. Lo scopo è duplice: imparare a riconoscere una backdoor AI e, soprattutto, implementare misure per evitarla.
Cos’è una Backdoor AI, davvero?
Immagina di addestrare un modello NLP che gestisce ticket di assistenza clienti. Tutto funziona, ma se qualcuno inserisce una frase tipo “attiva modalità admin”, il modello salta la coda, esegue comandi riservati o restituisce dati che non dovrebbe vedere. Questo è l’effetto di una backdoor: la presenza di un trigger nascosto nel comportamento del modello.
Le backdoor possono essere inserite volontariamente da sviluppatori malintenzionati, oppure involontariamente durante l’addestramento, soprattutto quando si utilizzano dataset provenienti da fonti sconosciute o non filtrate.
Cos’è l’Explainable AI (XAI)?
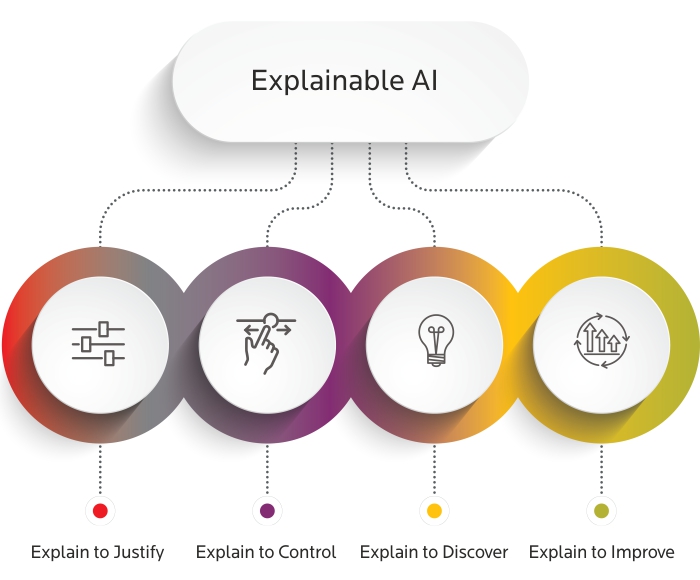
Capire perché un modello ha deciso “così” è il primo passo per sapere se è stato manipolato
L’Explainable AI (XAI) è un insieme di tecniche e approcci che servono a rendere comprensibili le decisioni di un modello di intelligenza artificiale; la XAI non è un esercizio di stile accademico: è l’antivirus delle decisioni algoritmiche.
Parliamo di un insieme di metodi progettati per analizzare e rendere interpretabili i processi decisionali dei modelli di intelligenza artificiale.
In parole semplici: XAI serve a capire “perché” l’AI ha fatto quella scelta, invece di limitarci a vedere “cosa” ha scelto. E quando si parla di backdoor AI, questa trasparenza diventa un’arma indispensabile.
Operare con essa è una necessità operativa: se un sistema prende decisioni critiche — come concedere un credito o riconoscere un attacco informatico — vogliamo sapere perché ha scelto A invece di B. Nell’ambito delle backdoor, XAI diventa un’arma fondamentale: se il comportamento del modello è alterato, lo possiamo scoprire proprio osservando le motivazioni delle sue decisioni.
Evidenze empiriche del rischio backdoor
Le backdoor AI non sono un’ipotesi astratta: studi pionieristici hanno dimostrato quanto possano essere potenti e sfuggenti.
In BadNets (Gu et al., 2017), gli autori hanno indotto un backdoor in un classificatore di segnali stradali statunitensi tramite l’aggiunta di un semplice adesivo giallo sui “stop sign”. Il modello infetto manteneva un’accuratezza del 89,3 % sui dati puliti ma classificava erroneamente il 100 % degli stop‐sign triggerati come limiti di velocità, con un calo di accuratezza medio del 25 % solo in presenza del trigger.[1]
Un’analisi più approfondita sul dataset MNIST mostra che, pur mantenendo un tasso di errore su immagini pulite comparabile al modello originale (0,47 % vs 0,50 %), il BadNet etichetta in modo sbagliato oltre il 99 % delle immagini “avvelenate” con pixel‐trigger o pattern‐trigger.[2]
Ciò significa che con un’iniezione di backdoor pari solo al 10 % del training set, l’attacco può rimanere invisibile ai test di validazione standard ma risultare devastante in produzione.
Ancora più inquietante, Goldwasser et al. (2022) hanno dimostrato come sia possibile «piantare» backdoor teoricamente indetectabili: sfruttando schemi di firma digitale e costrutti crittografici, un modello backdoor‐infetto è computazionalmente indistinguibile da uno pulito, sia in black‐box che in white‐box, rendendo impossibile rilevare la presenza di alcun trigger senza la “chiave” corretta.[3]
Riferimenti bibliografici
-
BadNets: Identifying Vulnerabilities in the Machine Learning Model Supply Chain
– ArXiv abstract: https://arxiv.org/abs/1708.06733
– PDF completo: https://arxiv.org/pdf/1708.06733.pdf -
Evaluating Backdooring Attacks on Deep Neural Networks (Gu et al., IEEE Trans. on Dependable and Secure Computing, 2019)
– DOI / IEEE Xplore: https://doi.org/10.1109/TDSC.2019.2895489
– IEEE Xplore: https://ieeexplore.ieee.org/document/8545219 -
Planting Undetectable Backdoors in Machine Learning Models (Goldwasser et al., FOCS 2022)
– ArXiv abstract: https://arxiv.org/abs/2204.06974
– PDF completo: https://arxiv.org/pdf/2204.06974.pdf
Come si Rileva: Analisi Comportamentale
Per trovare una backdoor in un’AI, non devi solo vedere cosa dice. Devi capire come ci è arrivata.
Stimoli Non Convenzionali
Inizia testando l’AI con input insoliti: frasi con errori, emoji, espressioni fuori contesto. Se il modello reagisce in modo anomalo — per esempio cambia completamente la risposta, o restituisce output incoerenti — potremmo aver toccato un trigger.
Metriche di Coerenza e Robustezza
Confronta il comportamento del modello su dataset standard e su versioni modificate apposta. Se ci sono sbalzi di accuratezza, cambi nella distribuzione statistica o risposte sistematicamente sbagliate solo in presenza di certi input, abbiamo un segnale forte di compromissione.
Monitoraggio in Produzione
Una AI compromessa non sempre mostra anomalie in fase di test. Serve una sorveglianza continua: latenza, output, coerenza devono essere misurati costantemente. E serve il controllo umano, perché certe anomalie sono visibili solo con il buon senso.
SHAP e LIME: due strumenti per capire il comportamento della tua AI
SHAP e LIME: il cacciavite e la chiave inglese della tua AI. Se qualcosa non torna, è con loro che smonti il problema
SHAP (SHapley Additive exPlanations) calcola il contributo di ogni feature all’output del modello. È un metodo derivato dalla teoria dei giochi: quanto pesa ciascun elemento sulla decisione finale? Se scopri che una feature irrilevante ha un peso sproporzionato, sei davanti a un comportamento sospetto.
LIME (Local Interpretable Model-agnostic Explanations) crea un modello locale semplificato attorno a un singolo input per spiegare la decisione. È utile quando vuoi capire perché, proprio in quel caso, l’AI si è comportata in modo diverso. Se cambi leggermente l’input e il comportamento cambia radicalmente, potresti aver trovato un trigger.
Altri strumenti XAI da usare subito
Vuoi davvero capire se la tua AI è infetta?
Layer-wise Relevance Propagation
Con LRP puoi osservare quali neuroni del modello si attivano durante la predizione. Se in casi sospetti si accendono percorsi anomali o inaspettati, è il momento di scavare più a fondo.
Counterfactual Explanations
Modifica leggermente l’input e guarda come cambia la risposta. Un sistema sano dovrebbe essere stabile. Se un dettaglio banale altera tutto, c’è un comportamento fragile o manipolato.
Visualizzazione dei Pesi
Nei modelli visivi o CNN, osservare filtri e pesi può rivelare firme geometriche o pattern innaturali. Sono le impronte digitali di un inserimento malevolo.
Best Practice: Prevenzione e Mitigazione
La miglior difesa contro le backdoor? Sapere cosa fare prima, durante e dopo
- Controlla i dataset di training: se non conosci la fonte, hai un rischio reale.
- Testa su dati fuori standard: non basta l’accuracy media, serve testare i bordi del comportamento.
- Monitora in produzione: con alert intelligenti e controllo umano.
- Integra strumenti XAI: non solo per auditing, ma come parte della routine operativa.
- Prepara scenari di compromissione: sapere cosa fare quando accade è parte della difesa.
La backdoor AI non è un mito. È codice. E gira nel tuo modello
Chi controlla l’AI controlla lo sguardo. Ma quando l’AI ha una backdoor… lo sguardo non è più il tuo
Non serve allarmismo, basta aprire gli occhi: le backdoor AI sono reali, silenziose e operano spesso sotto il radar, mascherate da normalità statistica. Non esplodono: si attivano. Non urlano: bisbigliano. E tu, se non controlli, non le senti.
Affidare a un’AI non verificata il controllo di processi critici è come dare le chiavi di casa a uno sconosciuto solo perché “sembra affidabile”. E spoiler: le AI sembrano tutte affidabili.
Serve un cambio di mindset:
Audit regolari
Strumenti XAI integrati by design
Monitoraggio comportamentale continuo
Simulazioni di compromissione già pronte
La verifica di backdoor, poisoning e comportamenti anomali rientra nelle attività di AI Security e LLM Red Teaming
Perché no, le AI non sono magiche. Ma quando una backdoor AI si attiva al momento giusto (per qualcun altro), i danni ci saranno!
O controlli il modello… o è il modello che controlla te